모아의 기웃기웃 · AI 이해하기 · 7편
AI는 물체의 위치와 모양을
어떻게 찾을까?
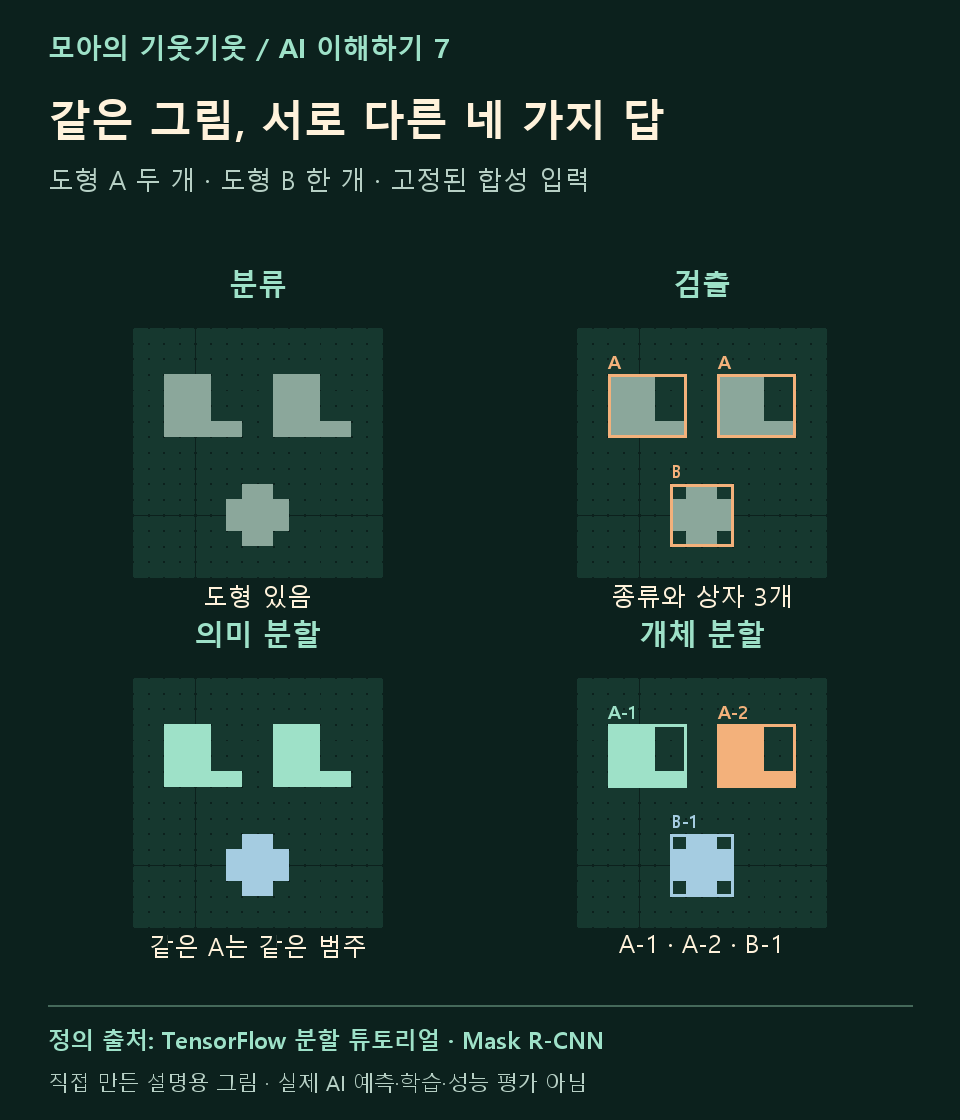
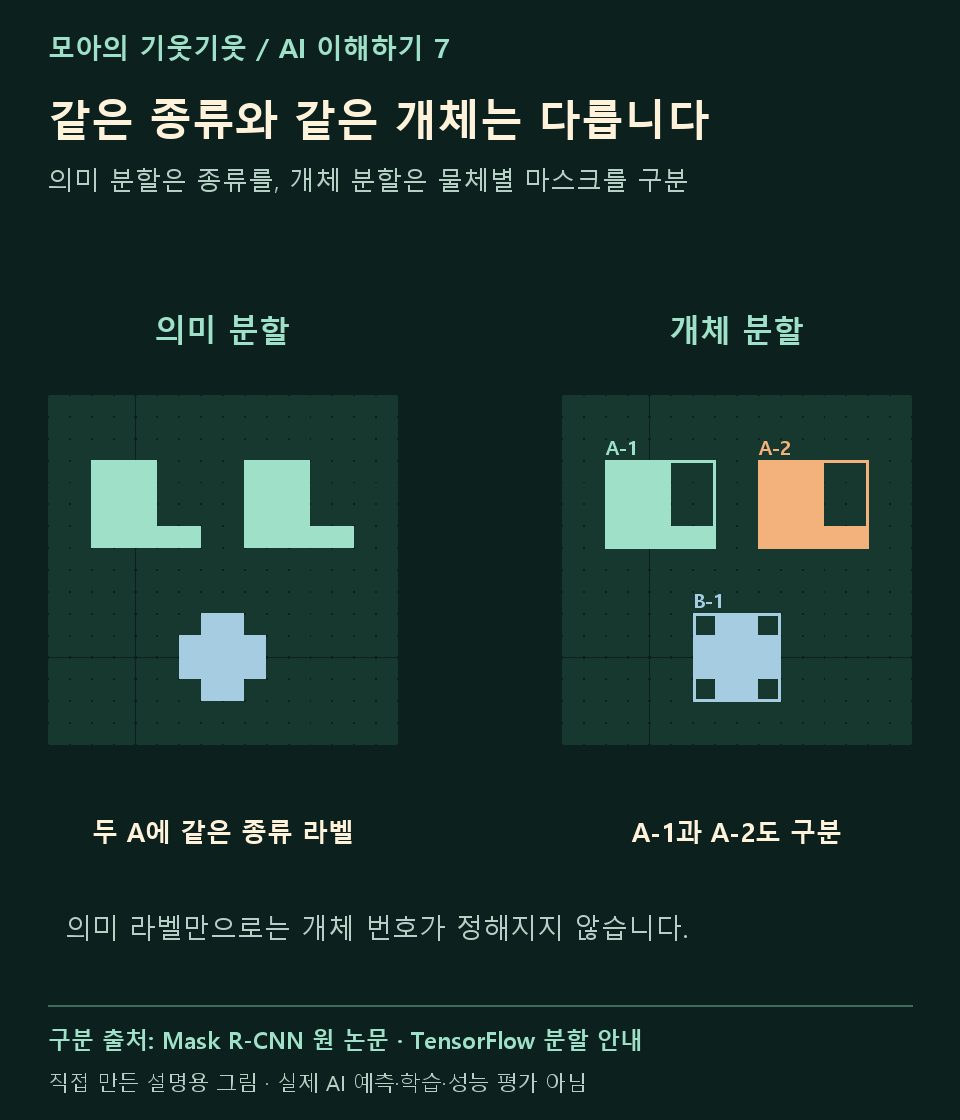
같은 그림을 보고도 ‘무엇이 있나’, ‘어디에 있나’, ‘어떤 모양인가’는 서로 다른 답을 요구합니다.
같은 그림에서 답의 형태 바꾸기
직접 만든 16×16 도형 · 출력 형식 모식도 · 학습·AI 추론 없음. 같은 입력과 정해 둔 라벨로 차이를 보여줍니다.
1 / 4
고정된 입력 그림
분류
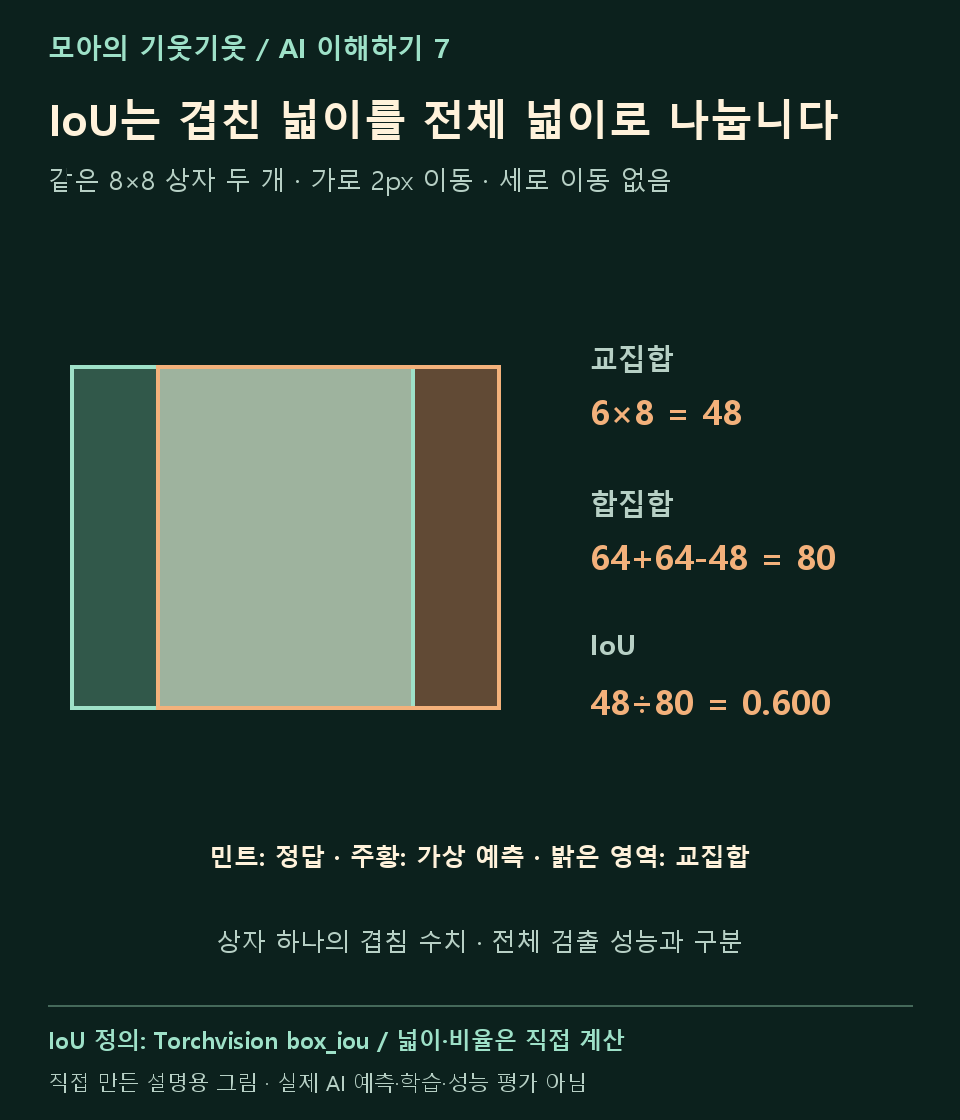
상자를 움직여 IoU 계산하기
두 상자는 같은 크기입니다. 직접 정한 정답·가상 예측 상자이며, 위 도형을 검출한 결과가 아닙니다.
민트 점선: 정답 · 주황 실선: 가상 예측 · 밝은 영역: 교집합
교집합
합집합
IoU
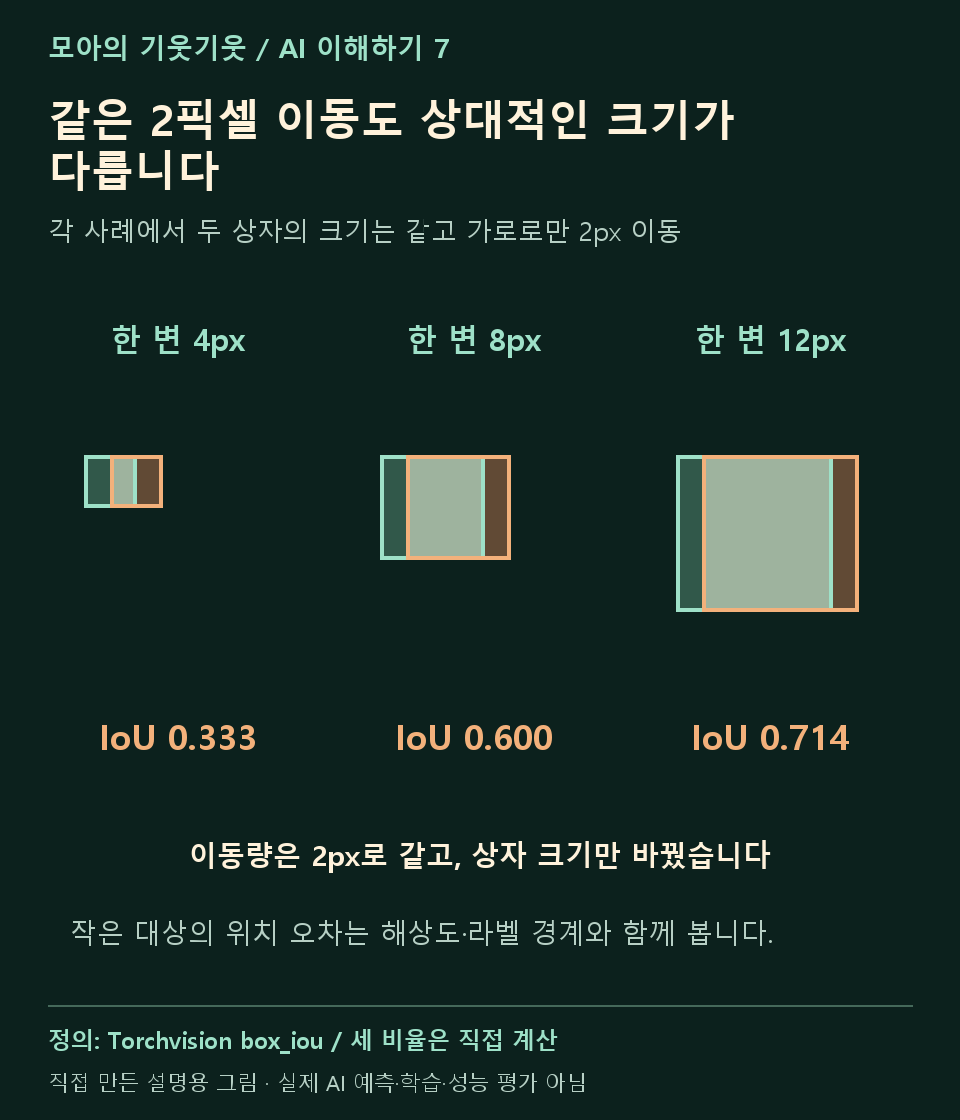
가로 2px·세로 0px에서 한 변 8픽셀은 0.600, 한 변 4픽셀은 약 0.333입니다. 같은 이동 오차의 상대적인 영향을 비교해 보세요.
더 알아보기 · 겹침 기준 바꾸기
상자 하나의 IoU와 전체 데이터의 AP는 다른 지표입니다. 종류·중복·정답 대응 관계도 평가해야 합니다.
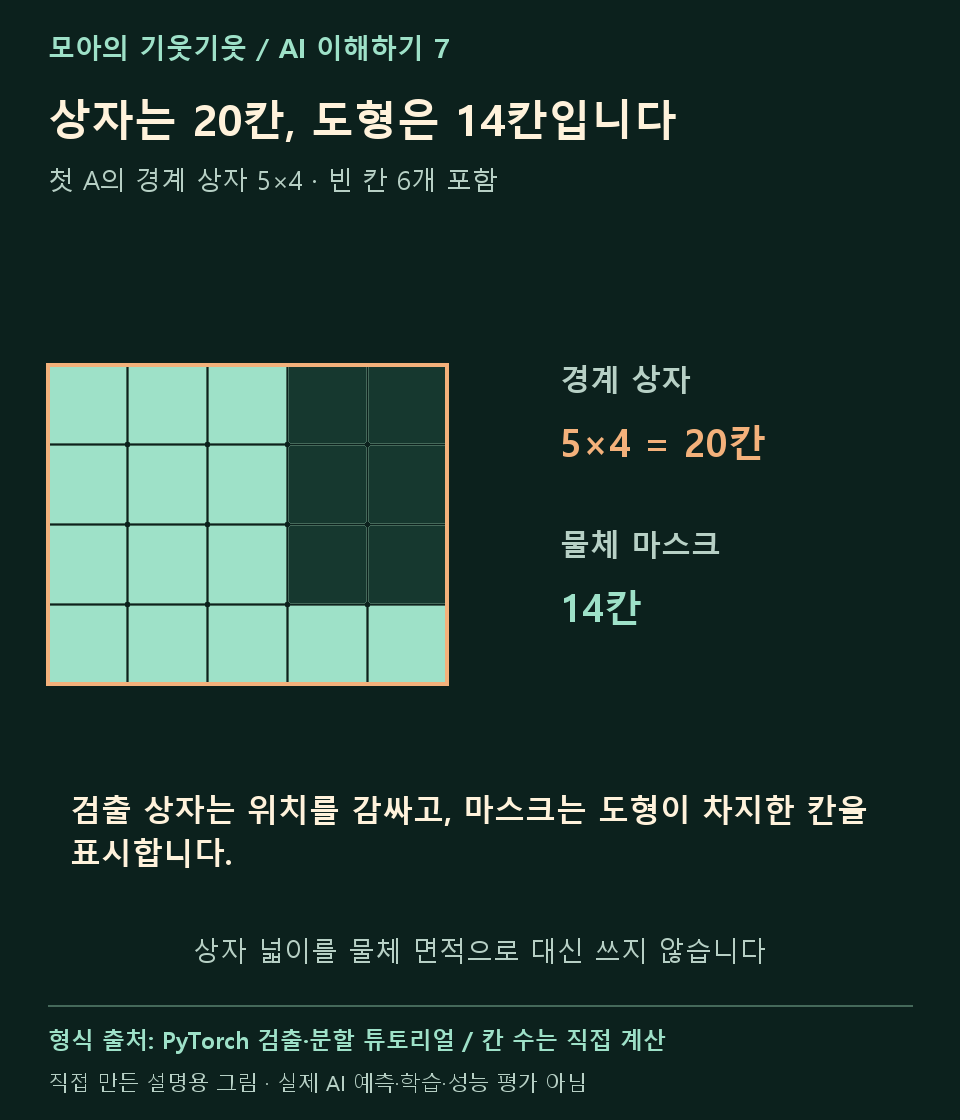
마스크와 상자 넓이는 다릅니다
첫 A는 마스크 14칸, 경계 상자 20칸입니다. 상자에는 빈 공간도 들어갑니다. 실제 면적을 구하려면 영상의 축척·보정도 필요합니다.
공식 예제의 수치와 구분하세요
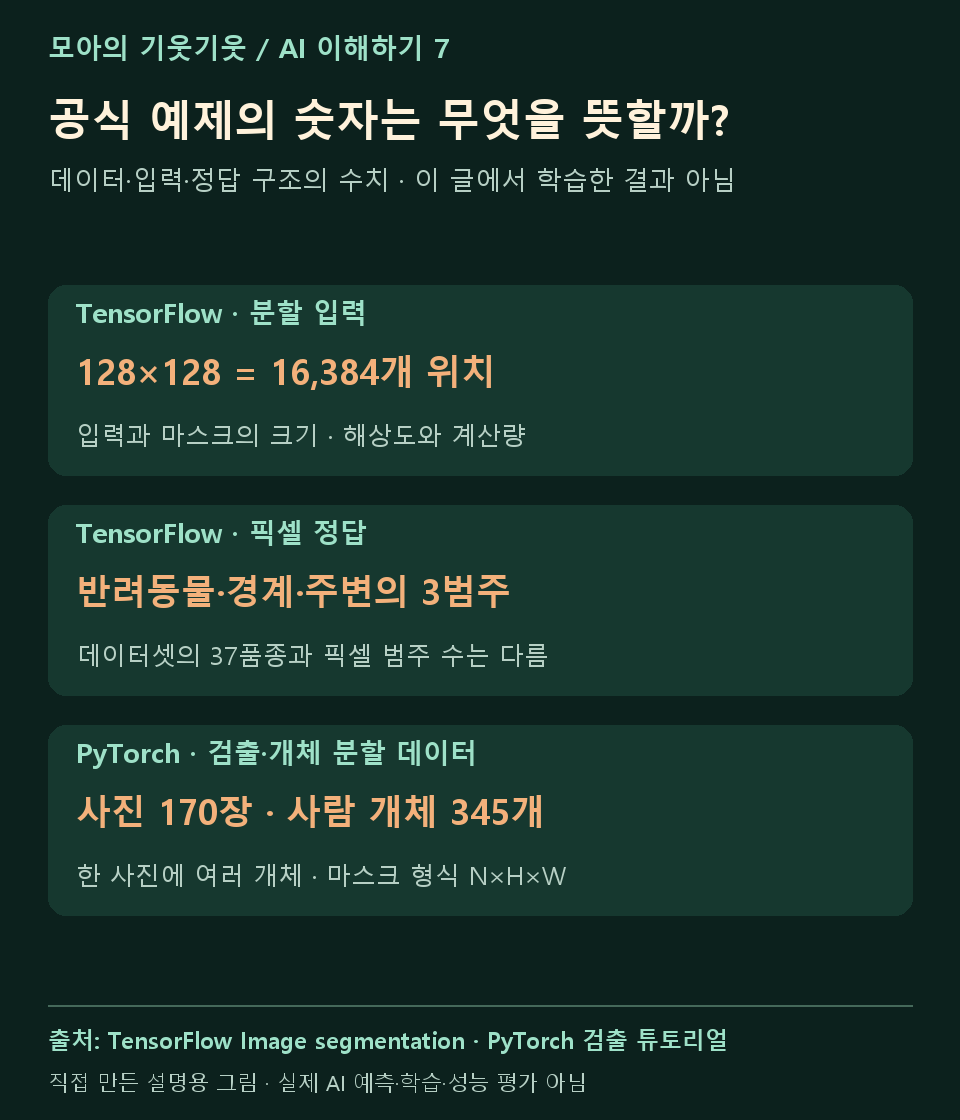
TensorFlow 분할 예제의 128×128은 16,384개 위치이고 픽셀 범주는 3개입니다. PyTorch의 별도 검출·개체 분할 예제는 이미지 170장과 사람 345개를 사용합니다. 이 실험은 해당 모델을 실행하지 않습니다.
그림으로 다시 보기
56초 영상
56초 · 한국어 자막 · 음성 없음