AI 이해하기 7편 · 모아의 기웃기웃
1편 학습의 원리 · 2편 최적화 · 3편 신경망 · 4편 과적합과 일반화 · 5편 데이터 품질 · 6편 CNN
AI가 사진을 보고 “물체가 있다”고 답했습니다. 그런데 우리가 필요한 것은 어디에 있는지, 혹은 어떤 모양인지일 수도 있어요.
지난 CNN 편에서는 작은 필터로 특징을 계산하는 과정을 봤습니다. 이번에는 그 특징을 이용해 어떤 형태의 답을 내놓도록 학습하는가를 살펴볼게요. 같은 그림에서도 이미지 전체의 라벨, 물체를 감싼 상자, 픽셀별 마스크는 서로 다른 답입니다.
1. 같은 그림에 서로 다른 질문을 해봐요
직접 만든 16×16 픽셀 그림에 ㄴ자 도형 A 두 개와 둥근 모양의 도형 B 한 개를 놓았습니다. 이름과 위치를 이미 정해 둔 설명용 그림이에요. 애니메이션은 출력 형식을 비교하고 넓이를 계산하며, AI를 학습하거나 실제 예측을 실행하지는 않습니다.
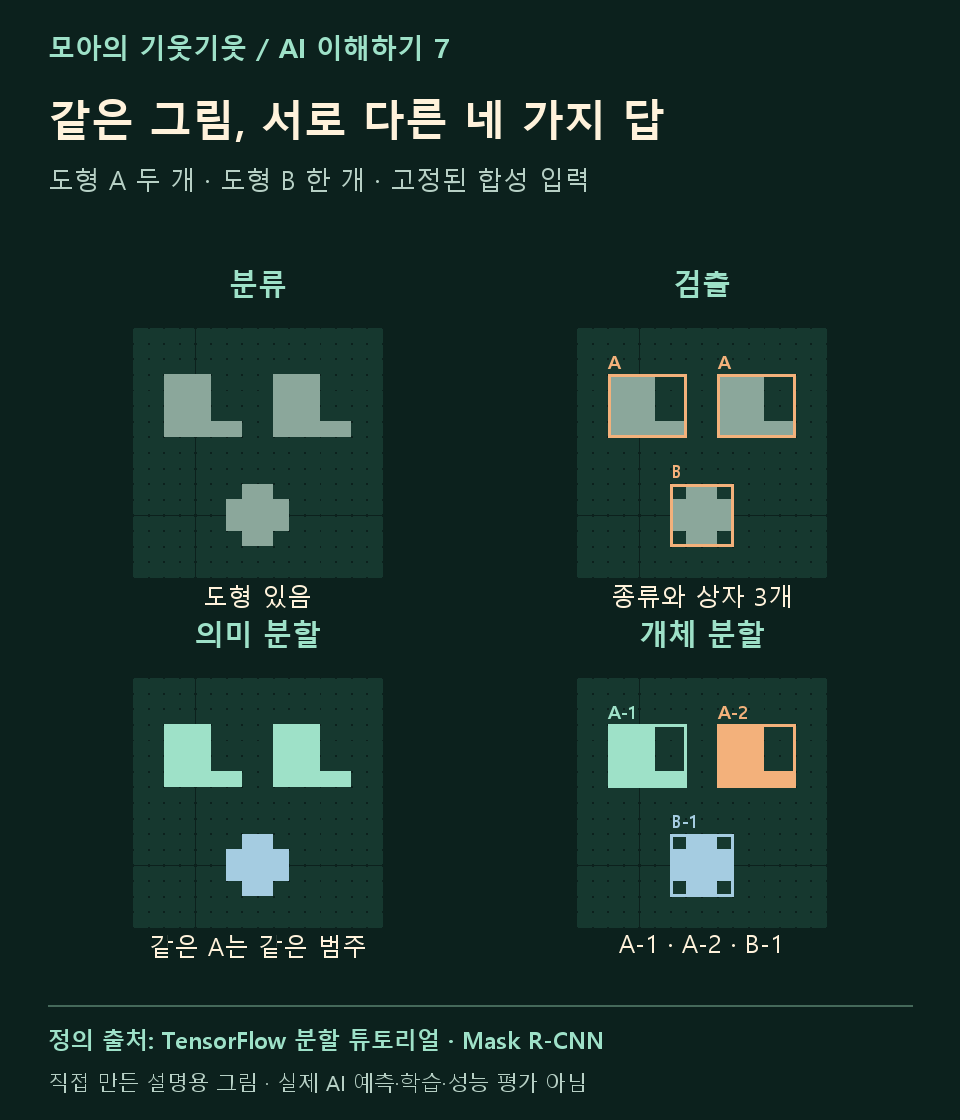
그림 1. 분류는 이미지의 라벨, 검출은 물체별 상자, 분할은 픽셀별 영역을 표현합니다. 모든 그림은 직접 제작한 설명용 모식도입니다.
| 하고 싶은 질문 | 대표 작업 | 답의 모습 |
|---|---|---|
| 이 그림에 도형이 있나요? | 이미지 분류 | 그림 전체에 대한 라벨 |
| A와 B가 어디에 있나요? | 객체 검출 | 물체별 종류와 경계 상자 |
| 어느 픽셀이 A·B인가요? | 의미 분할 | 픽셀마다 붙은 종류 라벨 |
| 같은 A 중 어느 것이 첫 번째인가요? | 개체 분할 | 물체별로 구분한 마스크 |
여기서 분류는 ‘도형 있음/없음’을 고르는 예입니다. 목적에 따라 이미지 전체를 여러 종류로 분류하거나 여러 라벨을 붙일 수도 있어요. 기본 구분은 TensorFlow의 분류·분할 설명과 PyTorch의 검출·개체 분할 예제를 참고했습니다.
2. 검출: 종류와 위치를 상자로 표현해요
객체 검출(object detection)은 물체별로 종류와 위치를 찾는 작업이에요. 위치는 흔히 경계 상자(bounding box)로 나타냅니다. PyTorch의 예제는 상자를 왼쪽 위와 오른쪽 아래의 좌표 네 개로 표현해요. 공식 상자·라벨 형식
우리 그림의 첫 A는 가로 좌표 2 이상 7 미만, 세로 좌표 3 이상 7 미만에 들어갑니다. 상자의 폭은 5픽셀, 높이는 4픽셀로 20픽셀²예요. 좌표는 픽셀 칸의 경계를 기준으로 잡았습니다.
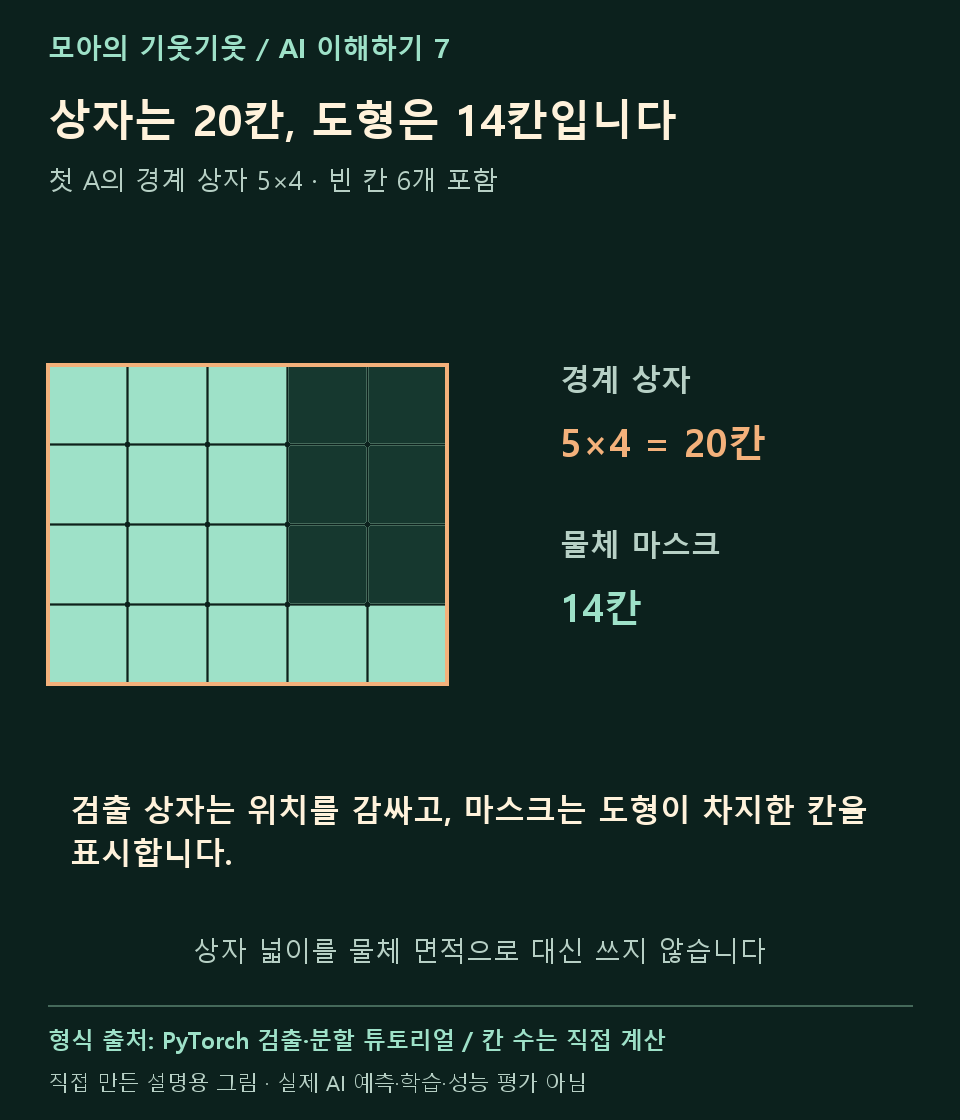
그림 2. 경계 상자에는 도형 바깥의 빈 칸 6개도 들어갑니다. 상자 넓이와 물체 마스크 넓이는 다릅니다.
ㄴ자 도형 자체는 14칸입니다. 상자 안에는 비어 있는 칸도 있으므로 상자 넓이 20을 물체 면적 14로 대신 쓰면 안 됩니다. 위치를 대략 표시할 때와 윤곽·면적을 다룰 때 필요한 출력이 달라지는 이유예요. 이 수치는 합성 그림에서 직접 센 값이며 실제 제품의 검사 성능이 아닙니다.
3. 분할: 같은 종류와 같은 개체는 다른 말이에요
이미지 분할(segmentation)은 픽셀별로 영역을 표현합니다. ‘어떤 종류인가’와 ‘어느 개체에 속하나’를 나누어 보면 두 방식의 차이가 쉬워져요.
- 의미 분할(semantic segmentation): 같은 종류인 두 A를 같은 범주로 표시합니다. A라는 라벨만으로는 첫 번째 A와 두 번째 A를 구분하지 않아요.
- 개체 분할(instance segmentation): 같은 종류라도 A-1, A-2처럼 각각의 물체를 구분합니다. 색은 이 구분을 설명하기 위한 표시예요.
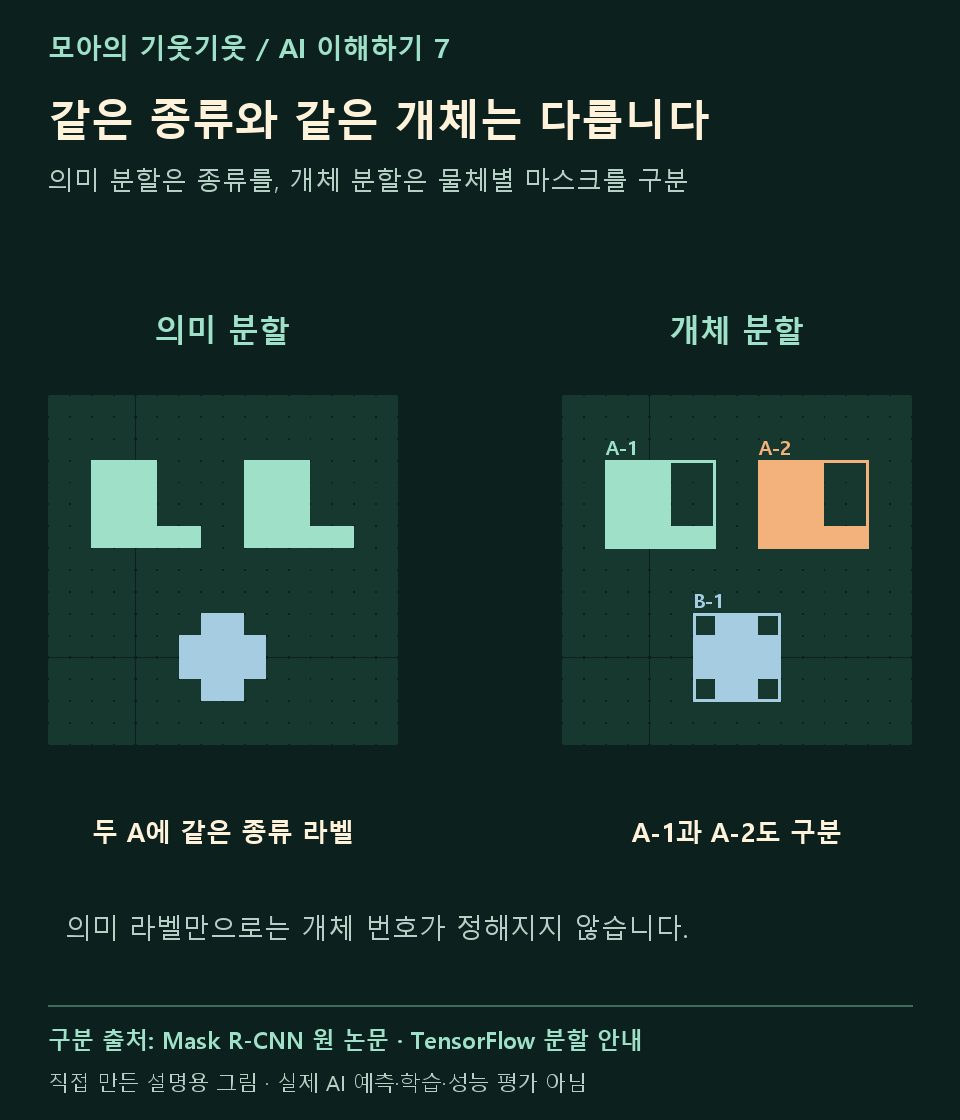
그림 3. 의미 분할도 영역이 떨어져 있으면 눈으로 두 덩어리를 볼 수 있습니다. 다만 종류 라벨 자체에 개체 번호가 들어 있지는 않습니다.
Mask R-CNN은 물체를 검출하면서 각 개체의 마스크를 만드는 모델의 한 예입니다. 모든 분할 모델이 이 구조를 쓰는 것은 아니에요. Mask R-CNN 원 논문
4. CNN의 특징은 어떻게 위치·마스크로 이어질까?
CNN에서 만든 특징 뒤에 필요한 답을 계산하는 부분을 연결하고, 그 답에 맞는 정답 데이터와 손실로 학습합니다. 분류에서는 이미지 라벨, 검출에서는 물체 종류와 상자, 분할에서는 픽셀별 라벨이나 개체 마스크가 필요해요.
분할 모델은 위치별 답을 내놓아야 합니다. U-Net은 문맥을 파악하는 축소 경로와 위치를 복원하는 확대 경로를 갖는 대표 구조예요. 해상도를 키우는 연산과 앞쪽의 위치 정보를 활용하는 연결을 사용합니다. 단순히 특징 지도를 크게 늘렸다고 정확한 윤곽이 저절로 생기는 것은 아닙니다. U-Net 원 논문
필요한 정답도 달라집니다. 이미지 라벨만 붙였던 데이터를 그대로 상자 정답이나 정밀한 마스크 정답처럼 사용할 수는 없어요. 라벨링의 비용과 추론 속도는 데이터·모델·해상도에 따라 달라지므로 ‘분할은 언제나 몇 배 느리다’처럼 고정된 순위로 외우지 않습니다.
5. 상자가 얼마나 겹쳤는지: IoU
정답 상자와 예측 상자를 비교할 때 쓰는 대표 수치가 IoU(Intersection over Union)예요. 겹친 넓이 ÷ 두 상자가 차지한 전체 넓이입니다. 전체 넓이인 합집합에서는 겹친 부분을 두 번 세지 않습니다. PyTorch의 상자 IoU 정의
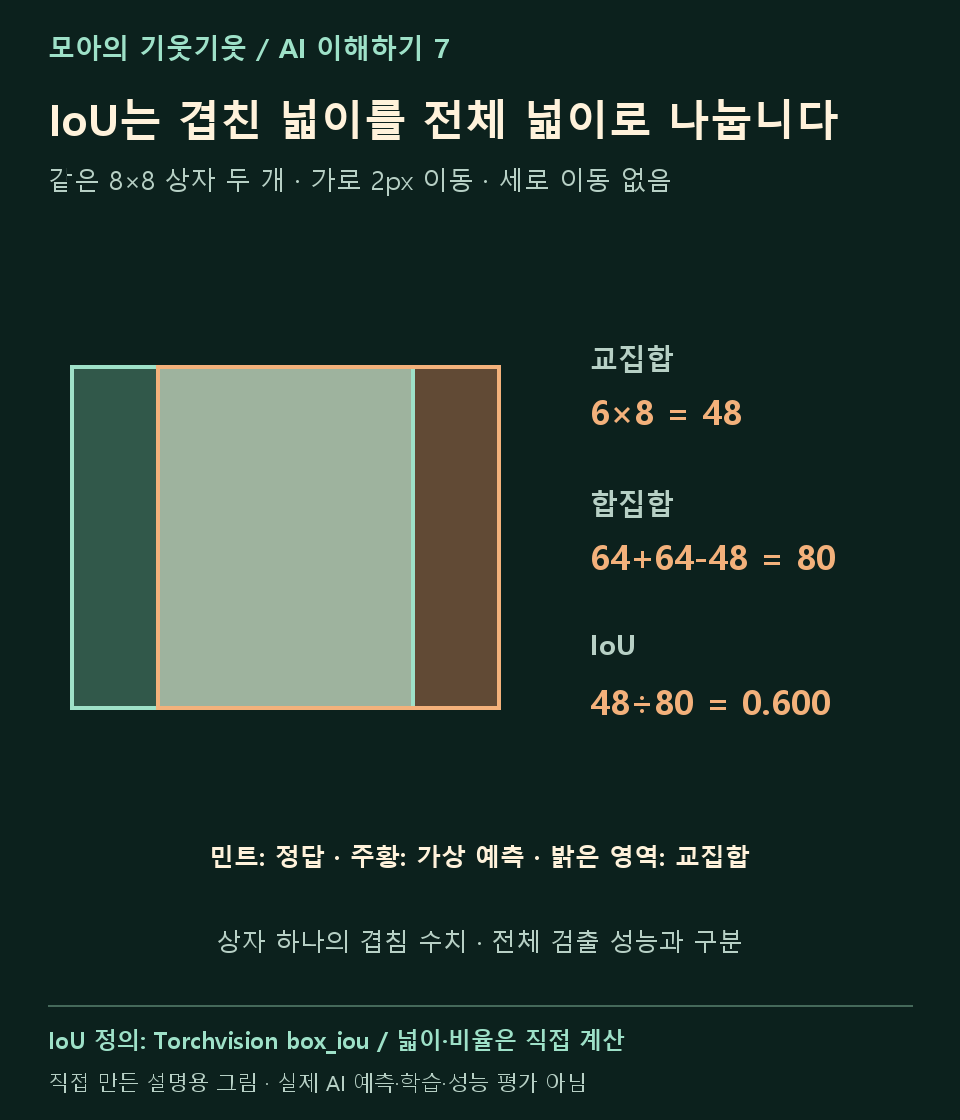
그림 4. 두 상자 모두 8×8이고 가로로만 2칸 어긋난 합성 예입니다. 애니메이션에서도 같은 계산을 사용합니다.
한 변이 8픽셀인 두 상자 중 하나를 가로로 2픽셀 옮겨 볼게요.
- 각 상자의 넓이: 8×8 = 64픽셀²
- 겹친 넓이: (8−2)×8 = 48픽셀²
- 합집합 넓이: 64+64−48 = 80픽셀²
- IoU: 48÷80 = 0.600
IoU가 1이면 두 영역이 완전히 겹치고, 겹치지 않으면 0입니다. 이것만으로 검출 전체의 성공 여부를 정하지는 않아요. 물체 종류, 예측과 정답의 대응 관계, 중복 검출 등도 확인해야 합니다.
6. 같은 2픽셀 오차라도 작은 물체에는 더 커요
한 변이 4픽셀인 두 상자를 가로로 2픽셀 어긋나게 놓으면 겹친 넓이는 8, 합집합은 24라서 IoU는 약 0.333입니다. 8픽셀 상자의 0.600보다 낮죠.
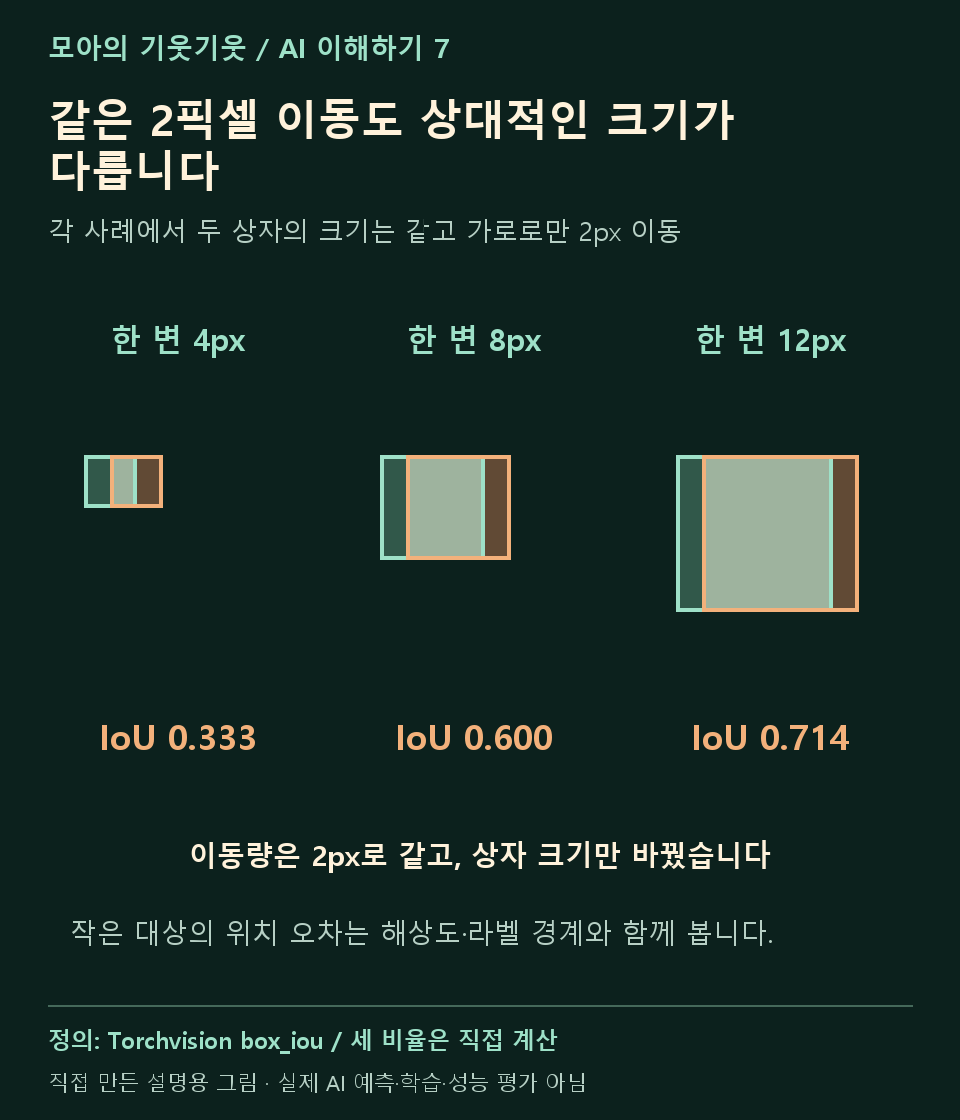
그림 5. 상자 두 개는 각 사례 안에서 크기가 같습니다. 이동량은 같고 상자의 크기만 바꾼 직접 계산입니다.
작은 대상에서는 몇 픽셀의 위치 차이가 상대적으로 크게 작용합니다. 입력 해상도와 물체 크기, 라벨 경계의 일관성을 함께 봐야 하는 이유예요. 이 예만으로 모든 작은 물체의 검출 성능이 반드시 낮다고 단정할 수는 없습니다.
7. 공식 예제의 실제 숫자는 이렇게 읽어요
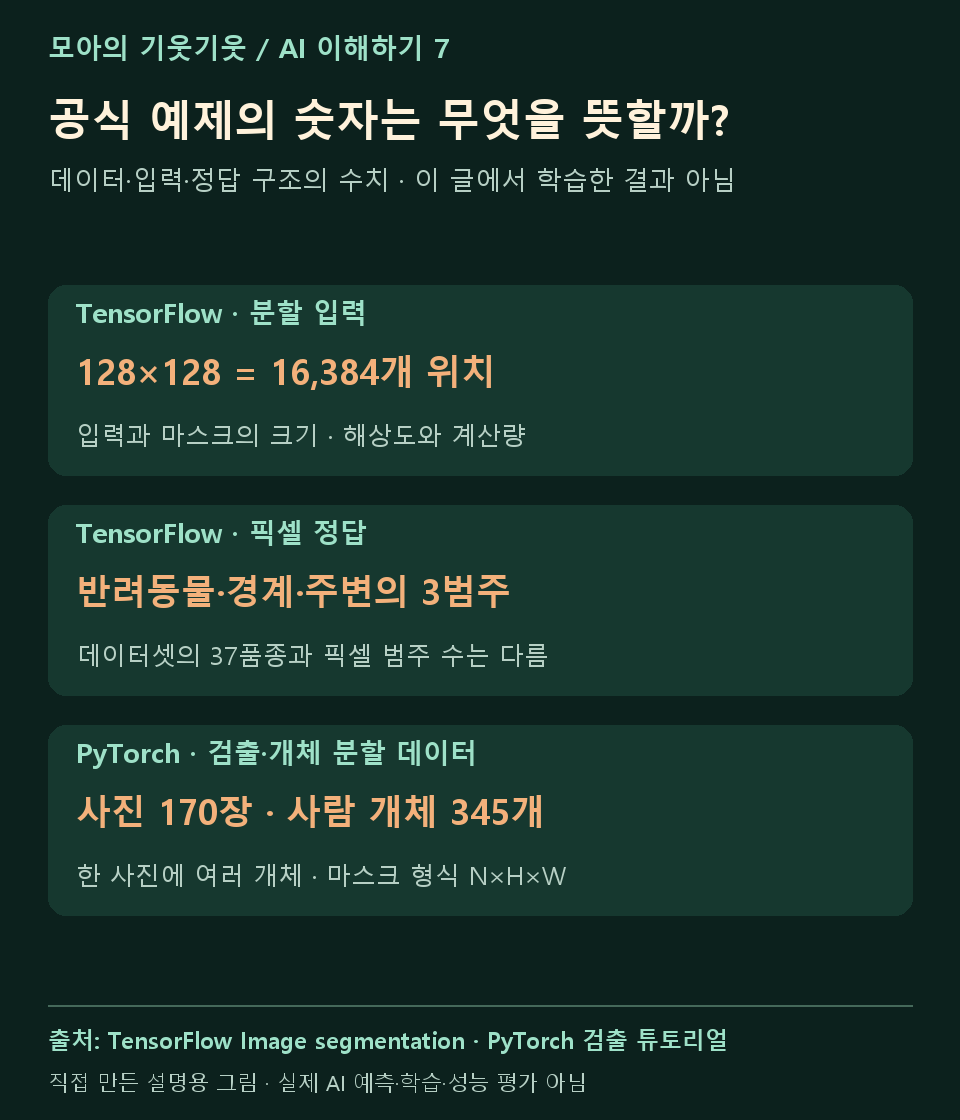
그림 6. 공개 튜토리얼의 데이터·구조 수치입니다. 이 글에서 모델을 학습해 얻은 정확도나 속도가 아닙니다.
TensorFlow의 분할 예제: 입력과 마스크를 128×128로 맞춥니다. 이는 16,384개 위치예요. 픽셀 범주는 반려동물·경계·주변의 3개입니다. 데이터셋의 37개 품종과 픽셀 범주 3개는 다른 숫자예요. 입력 크기는 세부 모양과 계산량에 관련되고, 범주의 정의는 어떤 정답을 학습하는지 결정합니다. 이 예제가 모든 물체의 개체 번호를 구분한다는 뜻은 아닙니다. TensorFlow 공식 분할 튜토리얼
PyTorch의 검출·개체 분할 예제: 사용한 Penn-Fudan 데이터는 이미지 170장, 사람 개체 345개입니다. 한 장에 여러 물체가 있을 수 있어 사진 수와 개체 수가 다릅니다. 예제는 물체별 상자·라벨과 선택적인 개체 마스크를 다루며, 마스크 형태는 개체 수 N과 이미지 높이 H·너비 W에 따른 N×H×W로 설명합니다. PyTorch 공식 튜토리얼
두 튜토리얼의 수치는 서로 다른 예제의 조건입니다. 합성 도형 실험과도 구분해 보세요.
직접 바꿔 보세요
- 같은 입력을 둔 채 분류·검출·의미 분할·개체 분할 버튼을 바꿉니다.
- 같은 A 두 개의 색과 개체 번호가 어떻게 달라지는지 봅니다.
- IoU 실험에서 한 변 8, 가로 이동 2, 세로 이동 0을 놓고 48÷80 = 0.600을 확인합니다.
- 가로 이동은 유지하고 한 변을 4로 바꿉니다. 같은 오차의 상대적인 영향을 비교합니다.
56초 · 한국어 자막 · 음성 없음
영상은 한국어 자막으로 구성했으며 음성은 없습니다. 그림과 애니메이션은 같은 합성 입력·좌표·계산을 사용합니다.
이번 편의 핵심은 필요한 답의 형태에 맞춰 작업과 정답 데이터를 정한다는 것입니다. 다음에는 결함이나 이상 사례를 충분히 모으기 어려울 때 사용하는 이상탐지로 이어가겠습니다.
더 알아보기: IoU 기준·마스크·평가 지표
IoU 0.5가 모든 작업의 합격선은 아닙니다. COCO의 대표 검출 평가는 0.50부터 0.95까지 0.05 간격인 10개 IoU 기준을 사용합니다. 이를 여러 클래스·예측 결과와 함께 평가해 AP를 계산합니다. 상자 하나의 IoU와 데이터셋 전체 AP는 다른 지표예요. 이 실험의 기준 선택은 겹침 조건만 보여줍니다. COCO 공식 평가 구현
마스크 IoU는 상자 대신 픽셀 집합의 교집합과 합집합을 비교합니다. Dice도 두 마스크의 겹침을 나타내는 지표지만 이번 편의 주 실험은 상자 IoU로 한정했습니다. 경계가 애매한 대상에서는 정답 마스크의 정의도 먼저 맞춰야 해요.
픽셀 수를 실제 면적으로 바꾸려면 영상의 축척·보정 조건을 알아야 합니다. 가상의 균일한 축척이 가로·세로 각각 0.5mm/픽셀이라면, 14칸의 면적은 14×0.5×0.5 = 3.5mm²입니다. 이 값은 설명용 가정이며 실제 카메라의 측정 결과가 아닙니다.
출처와 제작 기준
자료 확인: 2026년 11월 22일. 공개 문서의 수치와 합성 예제의 직접 계산을 구분했습니다. 그림·마스크·상자는 독립 제작한 설명용 자료이며 실제 검사 사진이나 학습된 AI의 예측·성능 평가 결과가 아닙니다.
- TensorFlow · Image segmentation: 분류·분할의 구분, 128×128·37품종·3픽셀 범주.
- PyTorch · Object Detection Finetuning Tutorial: 상자·라벨·마스크 형식, 이미지 170장·사람 345개.
- Torchvision · box_iou: 상자 간 교집합·합집합 비율.
- U-Net 원 논문, 2015: 축소·확대 경로와 위치 복원.
- Mask R-CNN 원 논문, 2017: 검출과 개체별 마스크 예측.
- COCO 공식 평가 구현: 여러 IoU 기준에서의 검출 평가.
#객체검출 #이미지분할 #의미분할 #개체분할 #컴퓨터비전 #CNN #IoU #딥러닝기초 #AI공부 #마스크 #AI이해하기 #모아의기웃기웃